Hace unas semanas me llegaron dos discos de 18 TB para el homelab. Ya tenía otros dos del mismo tamaño, cada uno montado como un pool de ZFS de un solo disco (más sobre ZFS en la sección 2) y, por encima de ambos, mergerfs. Así los presentaba bajo una única ruta, que me hacía la operativa más sencilla. El caso es que uno de esos dos discos estaba casi vacío y en el otro vivían los 9,84 TiB de multimedia, sin copia en ningún sitio. Era un apaño mientras llegaban los nuevos; el plan era pasar a una RAIDZ2 con los cuatro discos en cuanto los tuviese en casa.
Pues bien, ya los tenía, y resulta que no disponía de ningún lugar donde aparcar esos casi 10 TiB mientras montaba el pool, así que tuve que buscarme la vida. Este post trata de cómo monté una RAIDZ2 de cuatro discos teniendo solo tres libres, usando un fichero como cuarto disco hasta sustituirlo por el de verdad.
Por supuesto, cuando llega la hora del cacharreo viene con los prolegómenos inesperados: tras conectar los dos discos nuevos, al arrancar no había red, cosa que es un problema cuando trabajas con un servidor solo por ssh. Tuve que llevarme una pantalla, un teclado y terminar moviendo el homelab de habitación en habitación por si era cosa del RJ45. En el boot salía algún error, así que me puse a mirar logs, interfaces, IPs duplicadas, tablas ARP… Al final era cosa del hub tonto, se había quedado bloqueado, y tan solo tenía que haberlo reiniciado. Ya… ya…, lo de siempre: tres cuartos de hora perdidos por esta tontería. Pero se arregló.
Nota
Como en mis otros tutoriales, debo comentar que no soy ningún experto a bajo nivel en la materia. Tengo nociones de Linux porque hace tiempo que juego con él, pero no soy profesional de sistemas ni de coña. Mi trasfondo es de programador y de físico, por lo que comprendo un poco de la lógica formal de las cosas y otro poco del funcionamiento tangible de los objetos. La parte del entendimiento fundamental le corresponde a un ingeniero informático reglado; para mí todo esto es solo entretenimiento, un juego. Lo que quiero decir con esto es que lo que comparto puede estar errado. Por favor, si encontráis algún error de contenido o forma, hacédmelo saber.
Otra cosa. En este post se ejecutan comandos que destruyen pools y datos sin pedir confirmación (zpool destroy, labelclear, mkfs). NO copiéis y peguéis a ciegas. Cada uno va precedido de su comprobación, y los identificadores de disco son los míos, no los vuestros. Así que ojo, porfa.
1 - Índice
Índice
2 - De dónde partía
2.1 - ZFS en dos palabras
ZFS es a la vez sistema de archivos y gestor de volúmenes. Su unidad básica es el pool, un conjunto de discos que ZFS presenta como un único espacio de almacenamiento. Un pool se compone de uno o varios vdev (virtual device), y cada vdev es un grupo de discos físicos organizados de alguna manera, ya sea un disco suelto, un espejo o una RAIDZ. Dentro del pool van los datasets, que vienen a ser sistemas de archivos hijos con sus propias propiedades. Quien venga de BTRFS (cfr. hda-nas) verá que la filosofía es la misma: copy-on-write, checksums en cada bloque y snapshots. Más sobre los snapshots en la sección 8.2.
Mi caso era de lo más sencillo. Tenía dos pools, SERV-DATA1 y SERV-DATA2, cada uno con un único vdev de un único disco. SERV-DATA1 estaba casi vacío y SERV-DATA2 tenía los 9,84 TiB de multimedia. Por encima de los dos iba mergerfs.
2.2 - mergerfs
mergerfs es un union filesystem: coge varios directorios, que pueden estar en discos distintos, y los monta como si fuesen uno solo, repartiendo los ficheros nuevos entre ellos según la política que le configures. Es muy cómodo para tenerlo todo bajo una misma ruta sin reformatear ni mover nada. No da ninguna redundancia, así que si se muere un disco, lo que había en él se pierde sin más. Grosso modo es un JBOD (Just a Bunch Of Disks) con una capa de comodidad por encima.
Yo lo sabía y aun así tenía la multimedia en un solo disco sin segunda copia. Lo asumía porque es contenido que se puede volver a descargar y porque era algo temporal, aunque lo temporal me duró bastantes meses, jaja.
3 - RAIDZ2
3.1 - La paridad
¿Qué es una RAIDZ2? Es la versión de ZFS de una RAID 6, y para entenderla hay que entender primero la paridad, que es la idea en la que se apoya casi toda la redundancia por software.
La paridad más sencilla es la de un bit calculada con un XOR (un “o exclusivo”). Imaginad dos discos, A y B, y un tercer disco P en el que guardo el resultado de hacer A XOR B bloque a bloque. El XOR es reversible: si un día se muere el disco B, puedo recuperar cada uno de sus bloques calculando A XOR P. Con un solo disco de paridad sobrevivo a la pérdida de un disco cualquiera del conjunto. Esto, básicamente, sería una RAID 5, que en ZFS se llama RAIDZ1. Ya hablé de estos esquemas en hda-nas, cuando elegí SHR-2 para el Synology.
Una RAIDZ2 añade una segunda paridad, calculada de forma independiente de la primera con una matemática algo más elaborada que el XOR (códigos de Reed-Solomon, para quien quiera rascar). Con cuatro discos, dos equivalen a paridad y dos a datos, ergo el conjunto aguanta que se mueran dos discos a la vez sin perder nada. La contrapartida es quedarse con la mitad de la capacidad bruta: unos 32 TiB útiles de los 65,5 brutos.
¿Y por qué doble paridad, si una sola me dejaría más espacio? Porque con discos de este tamaño la reconstrucción de uno que haya fallado (el resilver, sección 8.8) dura horas, y durante esa ventana, con el resto de discos trabajando a destajo, la probabilidad de que caiga un segundo disco deja de ser despreciable. Por eso, lo habitual es pasar de paridad simple a doble en cuanto el conjunto maneja del orden de la decena de terabytes. Adam Leventhal lo razonó con números en ACM Queue allá por 2009, y desde entonces los discos han crecido mucho más rápido que su velocidad de lectura.
3.2 - Por qué no raidz_expansion
Cuando se monta una RAID los discos se formatean. Yo tenía 9,84 TiB de datos y ningún sitio donde aparcarlos, por lo que vaciar el disco, montar la RAID y copiar de vuelta quedaba descartado de salida. Sí tenía en mente hacer una expansión de RAIDZ. Una RAIDZ2 admite arrancar con su mínimo de tres discos (dos de paridad y uno de datos) y crecer después, así que el plan natural era crearla con el disco viejo vacío más los dos nuevos, copiarle encima los datos del viejo lleno y, una vez a salvo, añadir ese cuarto disco con raidz_expansion, que desde OpenZFS 2.3 (enero de 2025) permite ensanchar una RAIDZ en caliente.
El problema es que la expansión tiene letra pequeña. Cuando ZFS escribe en una RAIDZ, reparte cada bloque entre los discos con una proporción de datos y paridad que depende de cuántos discos haya en ese momento. Luego, al expandir, redistribuye los bloques viejos por el ancho nuevo, pero no recalcula esa proporción: lo escrito con tres discos conserva para siempre la relación dato-paridad de tres, y el pool acaba con dos eficiencias de almacenamiento mezcladas, desaprovechando capacidad frente a uno nacido con cuatro discos. Funciona y es seguro, pero queda subóptimo salvo que reescribas todos los datos a mano.
Dándole vueltas a esto con Claude salió otra opción, que permite crear el pool con su geometría definitiva desde el primer bloque. Es la que cuento a partir de aquí.
4 - El disco fantasma
El método del disco fantasma no lo he inventado yo; es un truco que circula desde hace años por los foros de ZFS. La clave es que una RAIDZ2 se puede crear ya degradada. Un pool degradado (DEGRADED en la jerga de ZFS) es uno al que le falta algún disco pero que sigue funcionando gracias a la paridad. Como una RAIDZ2 tolera dos ausencias, puedo crear un conjunto de cuatro miembros con solo tres discos reales y un cuarto miembro ausente. El pool nace degradado, pero operativo y todavía con una paridad de margen.
¿Y qué pongo como cuarto miembro, si no tengo un cuarto disco libre? ¡Un fichero disperso! ← esta es la magia.
4.1 - Ficheros dispersos
Un fichero disperso (sparse file) es un fichero que declara un tamaño grande pero no reserva en el disco los bloques que aún no contienen datos. El sistema de archivos apunta “este fichero mide 18 TB” sin escribir nada, y solo va ocupando espacio real a medida que se escribe de verdad sobre él. Si creo un fichero disperso de 100 GB y solo escribo 2 GB dentro, en el disco ocupa 2 GB, aunque al preguntarle su tamaño conteste 100. Es lo habitual en los discos de las máquinas virtuales: les das un tamaño máximo generoso y solo consumen lo que usa el huésped.
El fantasma es eso: un fichero que dice medir exactamente lo que un disco de 18 TB y que no ocupa nada, porque lo pondré offline en cuanto el pool exista, antes de que reciba una sola escritura. ZFS nunca le manda datos y por tanto nunca se materializa. Solo tiene que existir lo justo para que el pool crea que tiene su cuarto miembro.
4.2 - El plan
Con esto, el plan que me hice fue el siguiente:
- Mirar qué tiene SERV-DATA1 antes de destruirlo.
- Desmontar mergerfs con cuidado, manteniendo los datos de SERV-DATA2.
- Crear el fichero fantasma sobre el NVMe del sistema.
- Crear la RAIDZ2 con los tres discos libres y el disco fantasma.
- Degradar la RAIDZ2 a solo los tres discos físicos.
- Copiar el contenido de SERV-DATA2 a la RAIDZ2.
- Reemplazar el fantasma por el disco de SERV-DATA2, ya libre.
- …
- Profit.
Lo que me gusta del método es que el disco con los datos no se toca hasta el paso 7, y para entonces el pool nuevo ya guarda una copia completa con su propia redundancia (una RAIDZ2 degradada sigue tolerando un fallo). Justo antes de destruir el original hay dos copias de la multimedia, y una de ellas ya aguanta que se muera un disco.
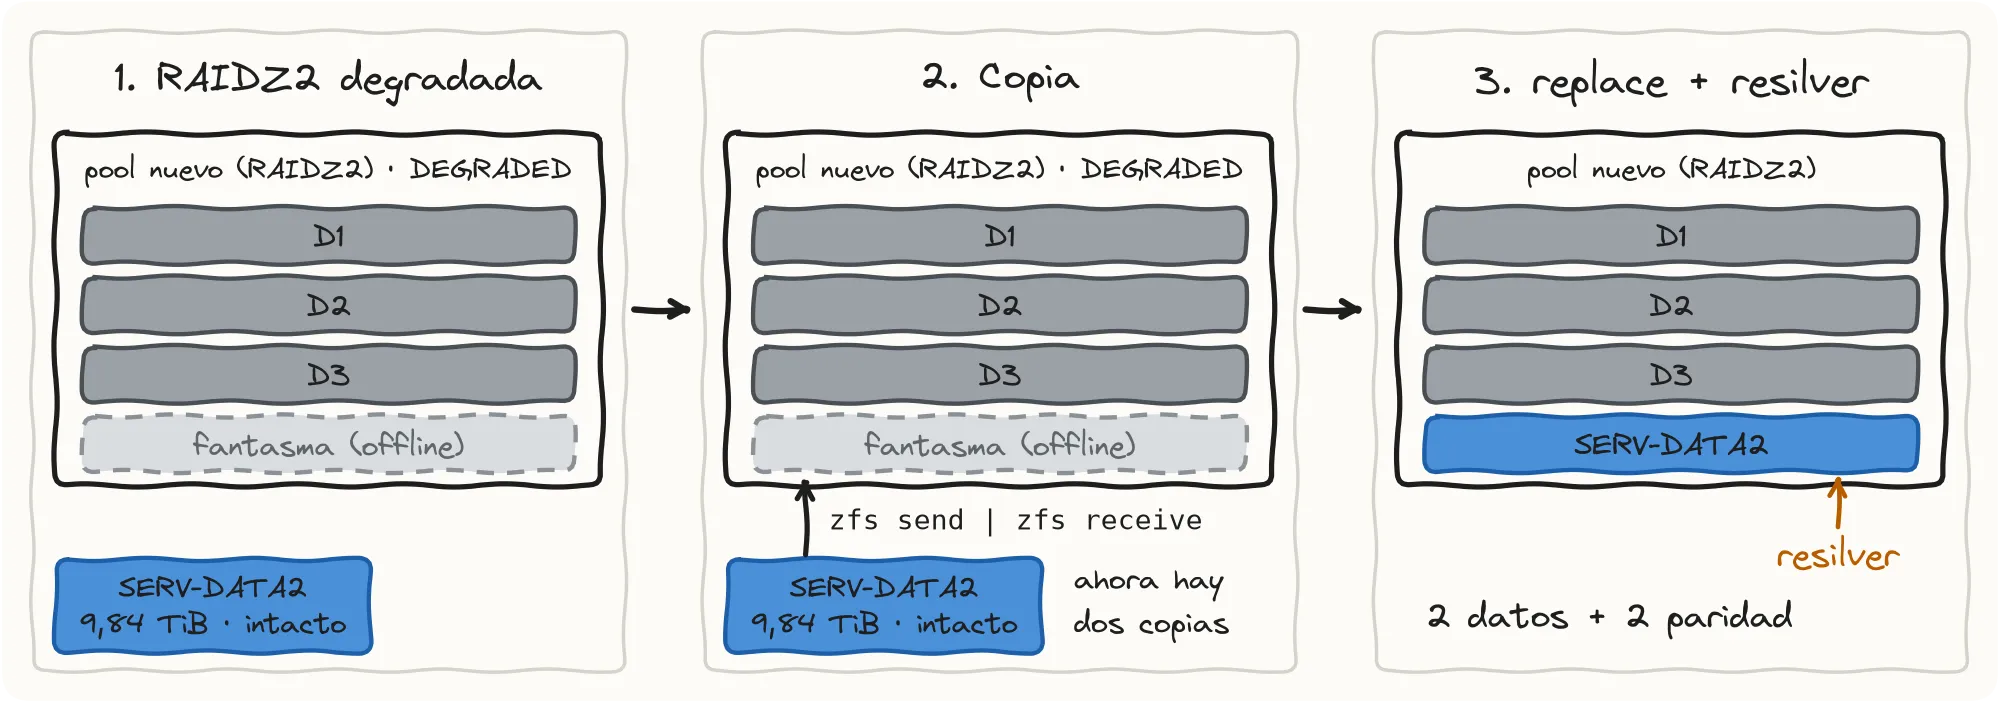
Imagen 1. Las tres fases del método. SERV-DATA2 no se toca hasta que el pool nuevo guarda una copia con redundancia propia.
5 - El límite de ext4
Ya con todo planeado y decidido me di con un problema. El plan era crear el fichero fantasma en /, la raíz del sistema, que vive en el NVMe de 1 TB del homelab, formateado en ext4 y con más de 600 GB libres. Como el fichero es disperso no iba a ocupar nada; solo tenía que declarar los 18 TB. Pues no:
❯ sudo truncate -s 17998060453888 /phantom.img
truncate: failed to truncate '/phantom.img' at 17998060453888 bytes: File too large
File too large. Ojo, el fichero disperso no ocupa nada, el problema es que ext4 tiene un tamaño máximo por fichero y me lo estaba saltando. Lo medí en lugar de fiarme de lo que dice internet:
❯ sudo truncate -s 16TiB /tmp_test.img
truncate: failed to truncate '/tmp_test.img' at 17592186044416 bytes: File too large
❯ sudo truncate -s 17592186040320 /tmp_test.img && echo "justo por debajo: OK"
justo por debajo: OK
Con bloques de 4 KiB, el techo de ext4 son 17 592 186 040 320 bytes, o sea, 16 TiB menos 4 KiB. ¿Y a mí qué, si mis discos son “de 18”? Pues que los fabricantes venden en TB decimales (10^12 bytes) y los sistemas de archivos cuentan en TiB binarios (2^40 bytes), que son un 10% más grandes. Es el eterno disco “de 1 TB” que Windows muestra como 931 GB. Mi disco de 18 TB son 16,37 TiB, por encima del techo de ext4. Lo pongo en una tabla, que así se ve mejor:
| Magnitud | Bytes |
|---|---|
| Disco real | 18 000 207 937 536 |
| Fantasma que necesito (disco menos 2 GiB) | 17 998 060 453 888 |
| Máximo que admite ext4 | 17 592 186 040 320 |
| Déficit | 405 874 413 568 (~378 GiB) |
Tabla 1. El fantasma no cabe en ext4 por unos 378 GiB. El margen de 2 GiB se explica en la sección 7.
Así que el fantasma en ext4 quedaba descartado y tocaba buscar otro sistema de archivos.
6 - XFS montado por loop
XFS admite ficheros de hasta 8 EiB (exbibytes), así que por ahí no iba a haber queja. El problema era dónde crear una partición XFS, porque el NVMe ya estaba entero repartido entre la partición EFI, la raíz y la swap:
❯ lsblk -o NAME,SIZE,FSTYPE,MOUNTPOINT /dev/nvme0n1
nvme0n1     931.5G
├─nvme0n1p1   512M vfat   /boot/efi
├─nvme0n1p2 930.1G ext4   /
└─nvme0n1p3   977M swap   [SWAP]
La solución fue montar el XFS dentro de un fichero con un dispositivo de loop. ¿Qué es un montaje por loop? Es la forma que tiene Linux de tratar un fichero corriente como si fuera un disco: le pones encima un sistema de archivos con mkfs, lo montas con la opción loop, y a partir de ahí ese fichero se comporta como una partición. Es lo mismo que pasa cuando montas una .iso sin grabar el DVD.
Hice un fichero-contenedor de 25 GB, lo formateé en XFS y lo monté por loop. El contenedor era pequeño a propósito: si el offline del fantasma fallase por lo que fuera y ZFS empezase a escribir en él de verdad, se toparía con los 25 GB enseguida, en vez de ir llenando en silencio la partición raíz con un fichero de 16 TiB.
❯ sudo mkdir -p /xfsphantom
❯ sudo truncate -s 25G /xfs-container.img
❯ sudo mkfs.xfs /xfs-container.img
sudo: mkfs.xfs: command not found
Debian no trae las herramientas de XFS de serie. Un sudo apt-get install -y xfsprogs y seguimos:
❯ sudo mkfs.xfs -f /xfs-container.img
❯ sudo mount -o loop /xfs-container.img /xfsphantom
❯ df -h /xfsphantom
Filesystem      Size  Used Avail Use% Mounted on
/dev/loop0       25G  211M   25G   1% /xfsphantom
Un apunte sobre el mkfs.xfs, que a mí me dio un respingo al teclearlo. Formatea el fichero, no una partición del NVMe. mkfs.xfs /dev/nvme0n1p2 habría sido un desastre; pero mkfs.xfs /xfs-container.img es inocuo. Mirad dos veces el argumento antes de darle a Intro, parfavar.
Y dentro del contenedor, ahora sí, el fantasma:
❯ sudo truncate -s 17998060453888 /xfsphantom/phantom.img
❯ stat -c '%s bytes, %b bloques reales' /xfsphantom/phantom.img
17998060453888 bytes, 0 bloques reales
El fichero declara 16,37 TiB y no ocupa ningún bloque.
6.1 - Un susto con el NVMe
Como el fantasma iba a vivir en el NVMe, me interesaba que el NVMe estuviese sano. Y resulta que al arrancar tras la intervención, smartd me había soltado un aviso de casi cuatrocientas entradas en el log de errores de ese disco. Me dio un vuelco, porque si se me muere el disco de arranque mal empezamos.
❯ sudo smartctl -a /dev/nvme0n1 | grep -E 'SMART overall|Media and Data|Error Information Log'
SMART overall-health self-assessment test result: PASSED
Media and Data Integrity Errors:    0
Error Information Log Entries: 398PASSED, cero errores de integridad de datos y ningún sector implicado. Las 398 entradas eran la misma condición repetida (Invalid Field in Command): el kernel le manda al disco en cada arranque un comando con un campo que el firmware de los Samsung de la serie 970 no soporta, y el disco lo anota como error. Es un problema conocido y benigno; el contador no se puede borrar sin formatear el namespace, así que ahí se queda. En fin.
7 - El tamaño del fantasma
El fantasma no mide exactamente lo que el disco real que lo sustituirá sino un poco menos, en concreto 2 GiB menos:
Disco real:   18 000 207 937 536 bytes
Margen:            2 147 483 648 bytes  (2 GiB)
Fantasma:     17 998 060 453 888 bytes
La razón está en el último paso. Cuando reemplace el fantasma por el disco real, ZFS exige que el disco entrante no sea más pequeño que el miembro al que sustituye. Si por diferencias de alineación de sectores el disco real quedase un pelo por debajo del fantasma, ZFS rechazaría el cambio y me dejaría el pool a medias, con el fantasma dentro y el disco fuera. Restando 2 GiB de antemano, el disco real entra con holgura. Esos 2 GiB son el 0,012% de la capacidad del vdev y además se recuperan después con autoexpand (sección 8.8). Quedarme corto, en cambio, habría significado rehacer la migración entera, con sus catorce horas de copia.
8 - Manos a la obra
Con el fantasma en su sitio, vamos con la ejecución. La mitad del trabajo fueron las comprobaciones, mejor ser precavido.
8.1 - Inventario de SERV-DATA1
Yo sabía que SERV-DATA1 al menos tenía cuatro cosas sin importancia, unos 30 GB. La idea era llevar el contenido de este disco a SERV-DATA2, para que con los nuevos y el fantasma se montase la RAIDZ2. Miré el contenido de SERV-DATA1 antes de destruir nada:
❯ zfs list -r SERV-DATA1
NAME                        USED  AVAIL     REFER  MOUNTPOINT
SERV-DATA1                 22.3G  16.2T     14.7G  /mnt/data1
SERV-DATA1/SERV-PROG-temp  7.55G  16.2T     7.52G  /mnt/data1/SERV-PROG-temp
Eran 22 GB, y entre ellos un backup de emergencia de 14 GB de una infraestructura anterior (un stream de zfs send de un snapshot llamado emergency_backup, nada menos) y 7,5 GB de configuraciones y secretos de varias generaciones del homelab: ficheros .env, claves de WireGuard, de Authelia, de Traefik. También estaban ahí los backups vivos del stack de finanzas (Firefly III, Ghostfolio y Wallos), 359 MB que mergerfs había ido colocando en este disco porque era el que más espacio libre tenía. Mi primer du me había dicho 8,5 KB, porque sin sudo no entraba en los directorios por permisos.
Copié los 22 GB a SERV-DATA2 y comprobé los md5 a ambos lados:
❯ sudo rsync -aHAX --info=progress2 /mnt/data1/SERV-PROG-backup/ /mnt/data2/SERV-PROG-backup/
❯ sudo cp -a /mnt/data1/SERV-PROG-full.zfs /mnt/data2/SERV-PROG-full.zfs
❯ sudo md5sum /mnt/data1/SERV-PROG-full.zfs /mnt/data2/SERV-PROG-full.zfs
cfef38186d25ff00e6f92ab24020325c  /mnt/data1/SERV-PROG-full.zfs
cfef38186d25ff00e6f92ab24020325c  /mnt/data2/SERV-PROG-full.zfs
Los backups del stack de finanzas los llevé al NVMe, junto al propio stack, conservando el propietario y el grupo con los que Syncthing los replicaba al NAS (parche temporal por la falta de redundancia), y reapunté las rutas en el .env. El NAS guarda la otra copia, así que durante la migración no se toca; al final habrá que volver a compartir la carpeta desde su sitio nuevo (sección 9). Es un homelab, no es producción, y puedo reconstruir lo que haga falta, pero por 22 GB en 6,5 TB libres no merecía la pena arriesgarse.
8.2 - Snapshot
Antes de copiar nada hice un snapshot de SERV-DATA2. ¿Qué es un snapshot de ZFS? Es una marca que congela el estado del sistema de archivos en un instante, sin copiar ni un bloque. Puede permitírselo porque ZFS nunca sobrescribe: cuando modificas un fichero, escribe los bloques nuevos en otro sitio y deja los viejos donde estaban (copy-on-write). Sin snapshot, esos bloques viejos se liberan; con snapshot, ZFS los conserva mientras el snapshot exista. Por eso crearlo cuesta 0 bytes, y por eso va ocupando espacio con el tiempo: lo que ocupa son los bloques que el dataset vivo ha cambiado o borrado desde la foto (meses después, ese snapshot llegaría a retener 2,25 TiB de bloques que el dataset ya no usaba).
❯ sudo zfs snapshot SERV-DATA2@migracion
❯ sudo zfs list -t snapshot
SERV-DATA2@migracion   0B   -   9.84T   -
Ocupa 0 bytes y referencia los 9,84 TiB. Me sirve para dos cosas: como punto de retorno si algo se tuerce, y como origen de la copia, que es lo que importa aquí. Si copiase el sistema de archivos vivo y algo escribiese a mitad, el resultado podría quedar incoherente; el snapshot no cambia, así que lo que viaja es siempre la misma foto.
8.3 - Desmontar mergerfs y destruir SERV-DATA1
Con un solo pool, mergerfs ya no pinta nada. Primero comprobé que ningún contenedor estuviese corriendo y que nadie tuviese abierto nada en el pool de mergerfs /SERV-DATA (si no, al desmontar sale el clásico target is busy):
❯ docker ps -a
... (todos Exited o Created, ninguno corriendo)
❯ sudo lsof /SERV-DATA
(vacío)
Después comenté la línea de mergerfs en /etc/fstab, sin borrarla, para poder volver atrás si hiciera falta, y desmonté:
❯ sudo cp /etc/fstab /etc/fstab.bak
❯ sudo sed -i '20s|^|#|' /etc/fstab
❯ sudo umount /SERV-DATA
❯ mount | grep -iE 'SERV-DATA|mergerfs'
SERV-DATA1 on /mnt/data1 type zfs (rw,noatime,xattr,noacl)
SERV-DATA2 on /mnt/data2 type zfs (rw,noatime,xattr,noacl)
Desmontar mergerfs no toca los datos de los pools que hay debajo; era solo la capa de unión. SERV-DATA2 seguía montado con todo dentro. Entonces destruí el pool vacío:
❯ sudo zpool status SERV-DATA1
SERV-DATA1  ONLINE  ... ata-ST18000NM002J-2TV133_XXXXXXXX  ONLINE
❯ sudo zpool destroy SERV-DATA1
zpool destroy no pregunta nada ni tiene papelera, así que antes miré tres veces que el pool que destruía era el vacío.
8.4 - Crear la RAIDZ2 degradada
El paso más delicado de toda la operación, porque un error de identificador aquí significa formatear la única copia de los datos. Trabajé siempre con los identificadores de /dev/disk/by-id/, que van atados al número de serie del disco y no cambian, y nunca con los /dev/sdX, que el kernel reasigna entre arranques como le da la gana.
Aun así, antes de crear nada me lo pregunté en voz alta: ¿seguro que ese Seagate es sda, el que acabo de destruir, y no el otro disco mecánico donde tenemos toda la data?
❯ readlink -f /dev/disk/by-id/ata-ST18000NM002J-2TV133_XXXXXXXX
/dev/sda     # disco viejo, recién liberado  → SÍ entra en el pool
❯ readlink -f /dev/disk/by-id/ata-ST18000NM002J-2TV133_YYYYYYYY
/dev/sdd     # los 9,84 TiB de datos          → NO entra
Confirmado, creamos la RAIDZ2 con los tres discos libres y el fantasma:
sudo zpool create -f -o ashift=12 \
  -O compression=lz4 -O atime=off -O xattr=sa \
  TANK raidz2 \
  ata-ST18000NM002J-2TV133_XXXXXXXX \
  ata-TOSHIBA_MG09ACA18TE_AAAAAAAA \
  ata-TOSHIBA_MG09ACA18TE_BBBBBBBB \
  /xfsphantom/phantom.img
Sobre las opciones: ashift=12 fija el tamaño de bloque del pool en 2^12 bytes, 4 KiB, que es el sector físico de los discos modernos, y hay que acertar de salida porque no se puede cambiar después. compression=lz4 activa una compresión muy barata en CPU que apenas roza el vídeo y las fotos (ya van comprimidos) pero ahorra en la metadata. atime=off evita escribir la fecha de último acceso cada vez que se lee un fichero. El nombre TANK es provisional, porque es feo; ya lo renombraré si me apetece.
Y sin perder un segundo, el fantasma fuera:
❯ sudo zpool offline TANK /xfsphantom/phantom.img
❯ sudo zpool status TANK
  pool: TANK
 state: DEGRADED
        raidz2-0                             DEGRADED
          ata-ST18000NM002J-2TV133_XXXXXXXX  ONLINE
          ata-TOSHIBA_MG09ACA18TE_AAAAAAAA   ONLINE
          ata-TOSHIBA_MG09ACA18TE_BBBBBBBB   ONLINE
          /xfsphantom/phantom.img            OFFLINE
errors: No known data errors
DEGRADED es justo el estado que buscaba. El fantasma así nunca recibió una escritura, el contenedor XFS no se llenó, y la RAIDZ2 conservaba una (1) paridad de margen. Por último fijé el recordsize en 1 MiB, que es el tamaño máximo de bloque lógico con el que ZFS trocea los ficheros. Para multimedia, con ficheros grandes, es lo recomendado: menos metadata y mejor rendimiento secuencial.
❯ sudo zfs set recordsize=1M TANK
❯ zpool list TANK
TANK  65.5T  1.79M  65.5T  ...  DEGRADED
Los 65,5T son los brutos (4 × 16,37 TiB sin descontar paridad); el útil se quedará en unos 32.
8.5 - Limitar la RAM de ZFS
¿No habría que limitar de alguna manera la RAM que se come ZFS? ZFS mantiene una caché en RAM llamada ARC (Adaptive Replacement Cache), que decide qué bloques conservar en memoria combinando lo más recientemente usado con lo más frecuentemente usado. Por defecto crece hasta la mitad de la RAM del sistema, que en mis 32 GB serían 16. Cede memoria cuando otro proceso la reclama, pero con cargas a ráfagas (bases de datos en contenedores, transcodificación de vídeo) ese tira y afloja se podría notar a veces. Lo limité a 8 GiB como punto de partida, dejando 24 GB para los servicios y el sistema. Esto no supone mucho problema, porque se puede ajustar en caliente, sin reiniciar:
❯ echo 8589934592 | sudo tee /sys/module/zfs/parameters/zfs_arc_max
❯ echo "options zfs zfs_arc_max=8589934592" | sudo tee /etc/modprobe.d/zfs.conf
❯ sudo update-initramfs -u
8.6 - La copia
Los datos se mueven con zfs send y zfs receive, el mecanismo nativo de ZFS para pasar datos entre pools. zfs send convierte un snapshot en un flujo de bytes por la salida estándar y zfs receive lo reconstruye como un dataset en el pool de destino. Entre medias lo pasé por pv, que muestra el progreso de lo que circula por una tubería, y lancé todo dentro de tmux, para que catorce horas de copia no se muriesen por un corte del SSH.
❯ sudo zfs send SERV-DATA2@migracion | pv -s 9840G | sudo zfs receive -v TANK/data
receiving full stream of SERV-DATA2@migracion into TANK/data@migracion
10.1TiB 14:45:01 [ 199MiB/s] [============================] 105%
received 10.1T stream in 53103 seconds (199M/sec)
10,1 TiB recibidos sin errores en catorce horas y tres cuartos, a 199 MB/s. El 105% es solo que el tamaño real superó la estimación que le pasé a pv. Durante toda la copia SERV-DATA2 solo se leyó; si algo hubiese reventado a mitad, seguiría ahí entero.
8.7 - Verificación
ZFS comprueba el checksum de cada bloque al recibirlo, así que lo que llega es idéntico al origen o falla haciendo ruido. Aun así quise comprobarlo por mi cuenta:
❯ sudo find /mnt/data2 -printf '%P\n' | sort > /tmp/origen.list
❯ sudo find /TANK/data  -printf '%P\n' | sort > /tmp/destino.list
❯ diff /tmp/origen.list /tmp/destino.list && echo "ESTRUCTURA IDENTICA"
ESTRUCTURA IDENTICA
❯ wc -l /tmp/origen.list /tmp/destino.list
   829610 /tmp/origen.list
   829610 /tmp/destino.list
829 610 entradas idénticas a cada lado, el REFER (el espacio que referencia el dataset) en 9,84 TiB en ambos, y los checksums de ZFS por su parte. Con esto ya me atreví a destruir el original.
8.8 - Reemplazar el fantasma por el disco
Lo último era jubilar al fantasma y meter en su sitio el disco de SERV-DATA2. Eso dispara un resilver: el proceso por el que ZFS reconstruye el contenido de un disco a partir de la paridad y los datos del resto del conjunto, hasta integrarlo del todo. Es lo que pasa cuando cambias un disco muerto por uno nuevo, y aquí el fantasma hace de disco muerto. Antes de nada activé autoexpand, que hace que el pool reclame el espacio nuevo cuando un disco se sustituye por otro mayor, para recuperar los 2 GiB del margen. Y a continuación fui a por el replace:
❯ sudo zpool set autoexpand=on TANK
❯ sudo zpool replace TANK /xfsphantom/phantom.img ata-ST18000NM002J-2TV133_YYYYYYYY
/dev/disk/by-id/ata-ST18000NM002J-2TV133_YYYYYYYY is in use and contains a unknown filesystem.
Falló, y menos mal: todavía no había destruido SERV-DATA2 y el disco seguía en uso, así que ZFS no lo aceptó. Al ir a destruirlo, otro tropiezo:
❯ sudo zpool destroy SERV-DATA2
cannot unmount '/mnt/data2': pool or dataset is busy
❯ sudo lsof +D /mnt/data2
COMMAND     PID USER   FD   TYPE DEVICE SIZE/OFF    NODE NAME
zsh     2963760  hda  cwd    DIR   0,40       12      34 /mnt/data2
find    2963763  hda  cwd    DIR   0,40       12      34 /mnt/data2
sort    2963765  hda  cwd    DIR   0,40       12      34 /mnt/data2
Un find zombi de la verificación anterior, con su sort y su shell, seguía con el directorio de trabajo en /mnt/data2. Maté los tres procesos y ahora sí:
❯ sudo zpool destroy SERV-DATA2
❯ sudo zpool labelclear -f /dev/sdd1 2>/dev/null
❯ sudo zpool labelclear -f /dev/sdd 2>/dev/null
❯ sudo zpool replace TANK /xfsphantom/phantom.img ata-ST18000NM002J-2TV133_YYYYYYYY
❯ sudo zpool status TANK
  pool: TANK
 state: DEGRADED
status: One or more devices is currently being resilvered.
        raidz2-0                               DEGRADED
          ata-ST18000NM002J-2TV133_XXXXXXXX    ONLINE
          ata-TOSHIBA_MG09ACA18TE_AAAAAAAA     ONLINE
          ata-TOSHIBA_MG09ACA18TE_BBBBBBBB     ONLINE
          replacing-3                          DEGRADED
            /xfsphantom/phantom.img            OFFLINE
            ata-ST18000NM002J-2TV133_YYYYYYYY  ONLINE
errors: No known data errors
El disco real entra como replacing-3, ocupando el sitio del fantasma, y ZFS calcula sobre él la parte que le toca hasta dejar la geometría final de dos discos de datos y dos de paridad. Mientras dura el resilver, el pool sigue tolerando un fallo.
9 - Después del resilver
Con el pool en ONLINE y sin rastro del replacing-3, quité el fantasma: desmonté el loop y borré el contenedor de 25 GB. zpool list confirmó que autoexpand había estirado el vdev al tamaño real de los discos, 65,5T brutos, con los 2 GiB del margen recuperados. Para montar TANK/data en /SERV-DATA no hizo falta tocar el fstab: en ZFS el punto de montaje es una propiedad del propio dataset (zfs set mountpoint=/SERV-DATA TANK/data) y el pool se monta solo al arrancar.
Lo del stack de finanzas se resolvió por otro camino. Un mes después el homelab pasó a dos VMs con KVM y el stack se mudó a la VM svc con sus propios sidecars de backup, así que la carpeta de backups del NVMe y su recompartición por Syncthing nunca llegaron a hacer falta. De esos backups hay hoy una sola copia, y la regla 3-2-1 que abrí en hda-nas se cerrará con la migración a Proxmox.
El pool pasa su scrub cada mes; el último, el 11 de octubre, sin un solo error en algo menos de quince horas.
10 - Palabras finales
¡Y ya está!, eso es todo. Muchas gracias por acompañarme hasta aquí. Hemos recorrido el punto de partida (dos pools de un disco y mergerfs), la razón de querer una RAIDZ2 y de no querer raidz_expansion, el truco del fichero disperso como cuarto disco, el muro de ext4 y la salida por XFS, y toda la operación con sus comprobaciones. Lo que me quedo de todo esto es que el disco con la única copia de los datos no se tocó hasta que el pool nuevo ya la guardaba con redundancia propia, y que cada comando destructivo fue detrás de una comprobación. Espero que el viaje os haya sido entretenido :)
10.1 - Para el futuro
El ARC acabó en 3 GiB, no en los 8 del arranque: con dos VMs en el host la RAM se quedó justa, y con esos 3 GiB la tasa de acierto ronda el 91 %, de sobra para servir multimedia. El scrub mensual lo programa el propio paquete zfsutils-linux de Debian, el segundo domingo de cada mes, así que ahí no hay nada que hacer. Lo que queda es el salto a Proxmox: exportar el pool, formatear el host con los dos NVMe en espejo e importarlo de nuevo. Pero eso es otra historia que merece otro post.
Versión 1.0R0 (17/10/2026)
Changelog
- Versión 1.0R0 (17/10/2026)
- Versión inicial.
Nota: este texto se ha escrito con asistencia de Claude (Fable 5.1), a partir de la transcripción de la propia sesión de trabajo y de la estructura y la voz de mis tutoriales anteriores.