El 25 de octubre, hablando de cómo calibrar las notas de destreza de la arena [esas de F a SSS de la entrega 7], escribí una frase que ha cambiado el proyecto más que cualquier decisión de diseño: «No descartemos hacer simulaciones de machine learning para esto, que es mi área. Sería un proyectito aparte; lo difícil es operativizarlo fuera de Godot». Esa misma noche añadí lo que de verdad me apetecía: si íbamos a montar un repositorio hermano para simular la arena, ¿por qué no otro para el tablero, con las dos tarjetas gráficas que tengo en casa? Y, sobre todo, me hacía muchísima ilusión aplicar a un juego mío el aprendizaje por refuerzoLa rama del aprendizaje automático en la que un agente aprende probando acciones y recibiendo recompensas, sin ejemplos etiquetados. (el de los agentes que aprenden jugando), que conozco bien de mi trabajo. Esta píldora va de ese proyectito: un modelo del tablero que juega dieciocho mil partidas por segundo en una GPU, una arena portada tick a tick a la tarjeta gráfica y para qué sirve todo eso en un juego tan asimétrico como este.
1 - El coste de medir
Todo lo que he contado de la IA se mide jugando partidas: la tabla de quién gana se calcula simulando duelos, y los atascos se ven en lotesUn conjunto de partidas o combates simulados de una tacada, con la misma configuración, para medir algo con cifras en lugar de con impresiones. de ochenta partidas. Cada una de esas medidas se hacía en Godot, que está pensado para jugar una partida cada vez, y se notaba: la tabla del paquete del producto tardaba 78 minutos la primera vez, un lote de 960 partidas, una hora, y la calibración de las notas pedía unos 120 milisegundos por duelo, de modo que una población de dos mil personas sintéticas costaba diez horas de CPU. La primera valoración de portar el combate fuera de Godot, el 25 de octubre, concluía que no compensaba: unas 4400 líneas de GDScript, un arnésEl andamiaje de pruebas que prepara unas entradas, ejecuta algo y compara su salida con lo esperado. de paridadQue dos programas distintos den exactamente el mismo resultado con las mismas entradas. Aquí, el juego y su simulador, duelo a duelo y bit a bit. y, sobre todo, mantener esa paridad a cada cambio del combate. Compensaría, decía, cuando una iteración necesitase del orden de un millón de duelos.
Dos días después el proyecto estaba parado esperando lotes. Escribí entonces que aquello iba a ser una parte recurrente del desarrollo, porque en la fase siguiente nos íbamos a dedicar a crear figuras nuevas y todos esos lotes se repetirían; que seguiríamos procesando duelos en Godot como puerta de confirmación de lo que obtuviéramos por el proxyUn sustituto más barato de la medida real, que se usa en su lugar y se confirma de vez en cuando contra ella. del simulador, y que había que escalar las simulaciones de la arena como habíamos hecho con las del tablero. Yo prefería la GPU, porque el speedupCuántas veces más rápido va algo después de un cambio. es real.
El porte era posible por lo que conté en la entrega 3: la arena es un contrato de determinismo, con paso fijo, aritmética entera sin un solo float, senos de punto fijo, un azar que solo sale de un generador contable con una multiplicación de 64 bits con desbordamiento y semillas derivadas con los primeros bytes de un SHA-256Una función de huella criptográfica: de cualquier dato saca 256 bits que cambian por completo si el dato cambia en algo.. Todo eso se escribe igual en cualquier lenguaje y, si se escribe bien, los bits coinciden.
2 - El tablero en tensores
El primer experimento fue el tablero, entre el 25 y el 26 de octubre, y partía de una idea mía que resultó correcta, aunque por razones que yo no sabía: bastaba con proyectar las reglas mínimas del juego en otro lenguaje mucho más rápido, sin emular un Godot entero. Al fin y al cabo es un ajedrez hipervitaminado, con tablero mutado y casillas de bonus y malus, y los resultados de los combates se podían leer directamente de la tabla que ya calcula la arena. Y si cabía en la GPU, más speedup aún.
Cabía, y lo que se copió (siguiendo mi regla de no reinventar la rueda y de mirar el estado del arte) fue el enfoque de bibliotecas como Pgx y JumanjiDos bibliotecas de investigación que implementan juegos de tablero como operaciones sobre tensores, para jugar miles de partidas a la vez en una GPU.: el estado de miles de partidas vive en tensoresUna matriz de cualquier número de dimensiones. Es el tipo de dato con el que trabajan las GPU y las bibliotecas de aprendizaje automático. [la posición de cada ficha de cada partida es una matriz, su vida otra] y cada regla es una operación sobre el lote entero. El alcance de todas las fichas de todas las partidas, por ejemplo, es una dilataciónOperación de tratamiento de imagen que expande una región un paso en todas direcciones. Repetida N veces, marca todo lo que está a N pasos. de máscarasUna matriz de verdaderos y falsos que marca qué casillas o qué partidas participan en una operación. Es como se escriben los condicionales cuando se opera sobre miles de partidas a la vez. repetida tantas veces como pasos tiene el mayor presupuesto de movimiento, en lugar de una búsqueda en anchura por ficha, y las reglas con ramas también se escriben con máscaras. Se hizo en PyTorchLa biblioteca de aprendizaje automático más usada en investigación, de Meta. Opera con tensores en CPU o en GPU. sobre CUDALa plataforma de NVIDIA para programar sus tarjetas gráficas., porque JAXLa biblioteca de Google para cálculo numérico con tensores y derivación automática, muy usada en investigación de aprendizaje por refuerzo. no tiene ruedasLos paquetes precompilados de Python (wheels). Sin ellos hay que compilar la biblioteca uno mismo. con GPU para Windows. El combate, en cambio, no se simula, se sortea con lo que el propio juego espera de él: se le pregunta a Godot su tabla de resultado esperado para cada pareja de figuras, piloto y vida, 202 500 consultas en un minuto.
Las cifras me parecieron de otro mundo. El arnés de Godot juega entre 0,2 y 1 partida por segundo con ocho procesos; el modelo, en una RTX 4090, unas 18 000 con un jugador aleatorio, unas 2000 con una red decidiendo cada orden y 30 000 con un paso de forma fija grabado en un grafo de CUDAGrabar una secuencia de operaciones de GPU una vez y relanzarla entera, sin que la CPU tenga que mandar cada una por separado. (que quita la latencia de lanzar cientos de núcleosUna función que se ejecuta en la GPU, en miles de hilos a la vez. En inglés, kernel. pequeños por paso). No es la misma partida, ojo, porque el modelo no tiene niebla, ni poderes, ni trampas, ni simula el combate; pero ese orden de magnitud, de cuatro a cinco cifras, es el que hace posible entrenar.
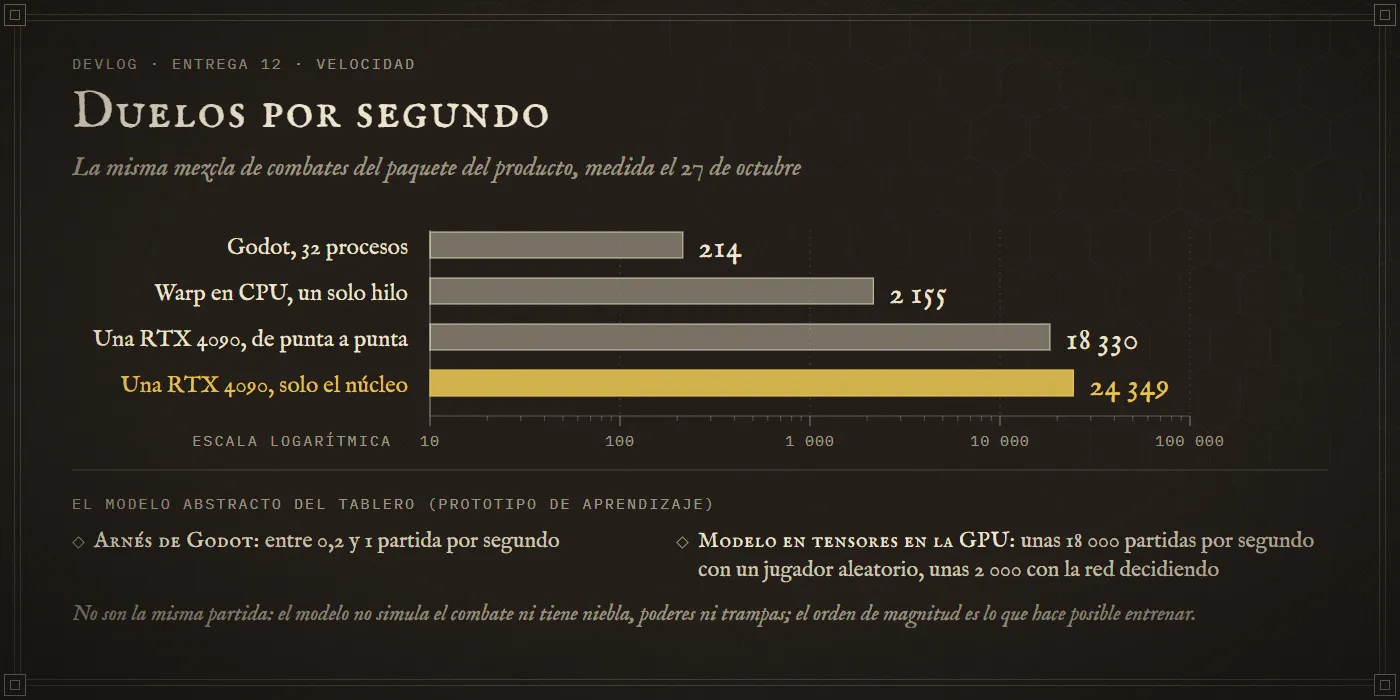
Imagen 1. Duelos por segundo de la arena, y partidas por segundo del modelo del tablero, medidos el 27 de octubre.
2.1 - Una red que juega contra sí misma
Con eso ya se podía entrenar una red, y se entrenó, con PPOProximal Policy Optimization, el algoritmo de aprendizaje por refuerzo más usado desde 2017. Mejora la política poco a poco, sin pasos bruscos. (el algoritmo de gradiente de política más usado) y con autojuegoEntrenar un agente haciéndolo jugar contra copias de sí mismo.: los dos asientos de cada partida los controla la misma red, cada uno viendo el tablero desde su lado. Para quien venga del aprendizaje supervisado, la políticaEn aprendizaje por refuerzo, la función que decide qué acción tomar en cada estado. Aquí, una red neuronal. es literalmente un clasificador que recibe el tablero y devuelve una distribución sobre las órdenes posibles; lo que cambia es de dónde salen las etiquetas, que son las órdenes que la propia red tomó, pesadas por lo bien que salieron. Las órdenes ilegales se enmascaran antes de la salida, de modo que la red nunca gasta capacidad en aprender qué es legal, y la cabeza está factorizada por ficha, como en las redes de punterosRedes cuya salida señala uno de los elementos de la entrada, en lugar de una clase fija. Sirven cuando el número de opciones cambia de un caso a otro., para que la misma red sirva para un mapa de ocho casillas de lado y para uno de trece. El riesgo conocido del autojuego puro es que la red se especialice contra sí misma, y la respuesta de manual es una población de rivales; aquí va en su forma mínima, y en la mitad de las partidas un asiento lo juega una copia congelada de la red de iteraciones pasadas.
Bastaron veinte minutos en una gráfica. Contra un rival codicioso, que siempre toma la mejor jugada inmediata con la misma tabla de combate, la red pasó del 33 por ciento de victorias al 68 con la reserva de rivales, mientras que el autojuego puro se estancó en el 54, tal y como predice la literatura.
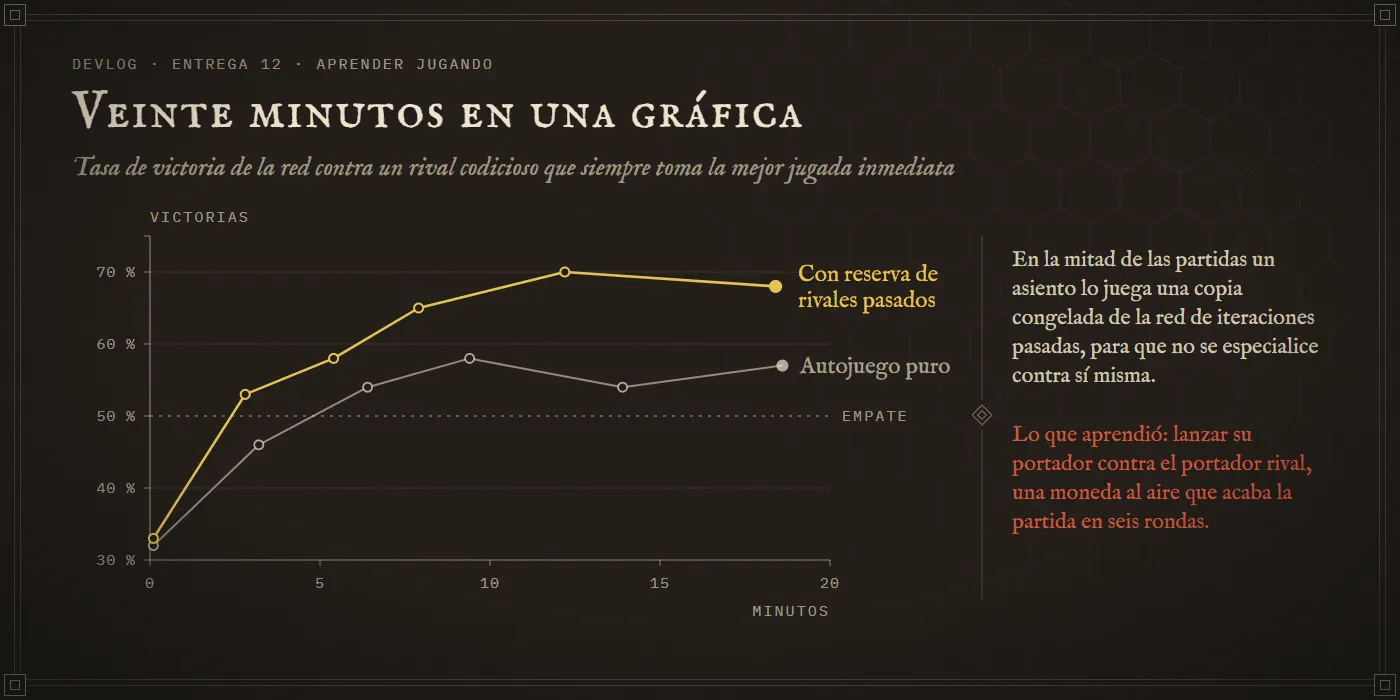
Imagen 2. Veinte minutos de entrenamiento contra un rival codicioso, con y sin reserva de rivales pasados.
Lo que más me gustó fue lo que aprendió. Contra el aleatorio, la red gana en unas seis rondas y ataca con su portador casi una vez por partida: en un mapa de ocho de lado, el portador es la pieza más fuerte, y lanzarlo contra el portador rival es una moneda al aire que termina la partida enseguida. Dos redes entrenadas, enfrentadas entre ellas, empatan al 50 por ciento con esa misma carrera. Es justo la clase de estrategia degenerada que quería que me encontrase una máquina antes que un jugador, y me deja un aviso sobre el portador que todavía no he resuelto. Hubo un segundo hallazgo, menos vistoso y bastante más útil: al comparar los combates del modelo con los de Godot salió que la tabla de resultado esperado de entonces no veía las muertes dobles en los espejos [las daba con probabilidad cero, y en el juego eran el 48 por ciento], y eso afectaba a la tabla del propio juego, más allá del modelo; lo destapó el prototipo, y se arregló con la arena simétrica de la entrega 3.
3 - La arena en Warp
La arena se portó el 27 de octubre a NVIDIA Warp, un marco para escribir núcleos de GPU en Python, con un hilo de GPU por duelo, aritmética entera y el mismo estilo escalar que el GDScript; el backendLa parte de una biblioteca que ejecuta el trabajo en un hardware concreto. El mismo código puede correr con el backend de CPU o con el de GPU. de CPU de Warp ejecuta el mismo código, y con él se depura la paridad. El porte es línea a línea, con los nombres y el orden del código del juego, y cada función dice en su documentación a qué función del juego corresponde, para poder portar un cambio futuro por diferencia de ficheros. Los objetos son filas de matrices de enteros, los nombres se convierten en índices, el tic simétrico va como en el juego y las semillas derivadas se calculan en el anfitriónEl ordenador que manda trabajo a la GPU: su CPU y su memoria. En inglés, host.. Compilar el módulo de CUDA cuesta unos cuatro minutos cada vez que cambia el porte (después queda en caché).
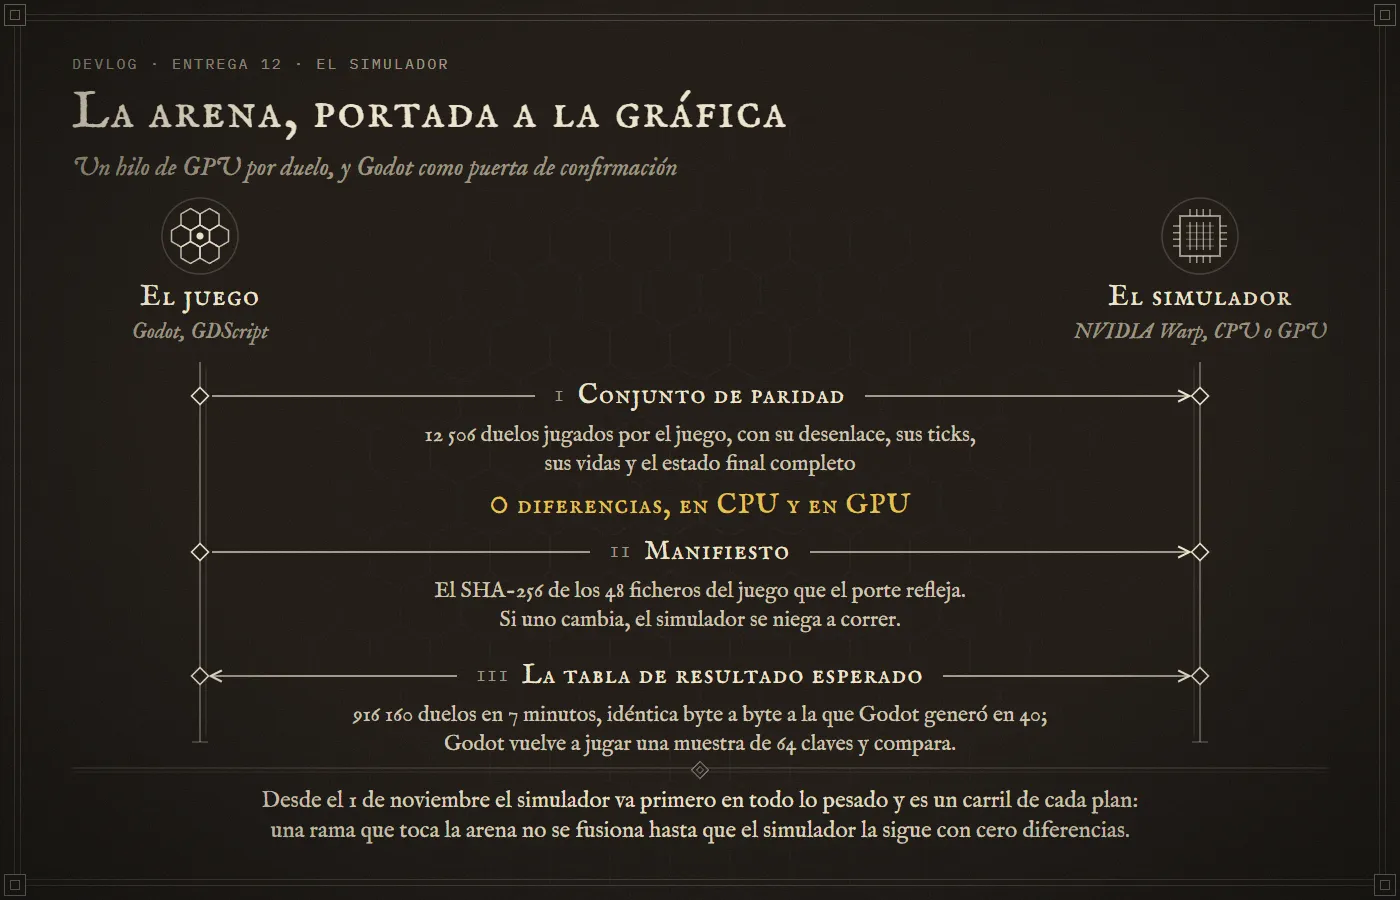
Imagen 3. El juego y su simulador: paridad, manifiesto y la tabla, con Godot como puerta de confirmación.
Lo que me quita el sueño de un simulador es la paridad, y lo dije el mismo día: me preocupaba que lo que fuéramos diseñando [figuras nuevas, reglas, modos] se separase entre Godot y el simulador sin que nadie lo notase. Así que la paridad se comprueba con un conjunto que construye el propio juego: para cada pareja de figuras, trece variantes de combate que cruzan cerebros, órdenes de asiento, fases del día, anillos, suerte, muerte súbita en distintos ticks, obstáculos, ilusiones y confusión, cada una con su resultado, sus ticks, sus vidas y el estado final completo con su hash, y un duelo coincide solo si coincide todo eso. A 1 de noviembre son 12 506 duelos, en dos paquetes y dos semillas, y dan cero diferencias en CPU y en GPU, en dos modos: reproduciendo las entradas grabadas, que prueba el combate, y jugándolos con los cerebros portados, que prueba la IA. Y el conjunto distingue: sin el tic simétrico salen 110 diferencias, sin una regla concreta del cerebro, 136, y sin la predicción del rival que camina, 1137, que es la cifra que me convence de que la prueba sirve.
Sean las cifras de velocidad, con la mezcla real de combates del paquete del producto: Godot con 32 procesos juega 214 duelos por segundo; Warp en CPU, con un solo hilo, 2155; una RTX 4090, 18 330 de punta a punta y 24 349 en el núcleo, y con los duelos sin obstáculos (que son las arenas del producto hoy), por encima de 89 000. Lo que limita, y esto lo aprendí a base de mirar perfilesMedir en qué partes del código se va el tiempo, con una herramienta que lo cronometra función a función., es que con un código tan serie y tan lleno de ramas un hilo de GPU es mucho más lento que un núcleo de CPU. Un lanzamiento dura lo que su duelo más lento, así que el rendimiento crece con el tamaño del lanzamiento, y una segunda GPU apenas ayuda, porque cada tanda es más corta y vuelve a mandar la latencia del duelo más lento. Hay cosas sin medir que probablemente ganen, como un grupo de procesos con el backend de CPU, pero de momento no me importa demasiado, porque la GPU ya hace en segundos lo que antes tardaba una tarde.
4 - El manifiesto, y el simulador primero
La respuesta a mi preocupación por la paridad, en realidad, fue más sencilla que el conjunto: un manifiesto. El simulador guarda el SHA-256 de los 48 ficheros del juego que el porte refleja, tal como estaban cuando alcanzó la paridad, y se niega a correr si alguno falta o cambió, nombrándolo. Tras portar un cambio y pasar la paridad, se vuelve a registrar. Si falla el modo de reproducción, el cambio está en el combate; si solo falla el de los cerebros, en la IA.
Desde el 1 de noviembre, además, hay una regla de trabajo por encima. Salió de un día en que me di cuenta de que seguíamos lanzando pruebas pesadas contra el motor del juego, en Godot, cuando el simulador era idéntico y treinta veces más rápido: el simulador va primero en todo lo pesado y es un carril de cada plan desde la primera tarea, y una rama que toque los ficheros portados no se fusiona hasta que el simulador la sigue con cero diferencias. La tabla de resultado esperado ya sale de él, 916 160 duelos en siete minutos frente a los cuarenta de Godot, y el documento es idéntico byte a byte al que generaba Godot; para comprobarlo, Godot juega de nuevo desde cero una muestra de sesenta y cuatro claves. Esa es la puerta de confirmación de la que hablaba, y de momento se queda.
5 - Para qué
¿Para qué todo esto? Para lo que me convenció el 27 de octubre, que copio porque lo mantengo: este juego tiene un potente factor asimétrico, con figuras distintas y libertad para comprarlas, que impacta directamente en el equilibrio, y se necesitan simulaciones para determinar las estrategias y los perfiles de piloto. En concreto, para equilibrar las figuras de la fase 6 con barridos de miles de duelos por ajuste, y buscar de paso estrategias dominantes, que merman el juego (aunque también podrían dinamizarlo si hubiera temporadas; no lo sé). Para calibrar los nueve pilotosEl perfil de destreza con el que la IA lleva una figura en la arena: cuánto tarda en reaccionar, cuánto adelanta al apuntar, cuánto duda. de la arena y los cinco tramos de dificultad de la entrega anterior, que sin esto serían una tarde por piloto. Y para ajustar los pesos de la evaluación de la posición con partidas enteras, que es el paso siguiente: portar también la partida de tablero completa, línea a línea, con paridad partida a partida contra Godot y con una puerta de rendimiento antes de seguir, porque nadie ha medido todavía si portar unas 39 500 líneas de reglas e IA acelera la partida tanto como aceleró la arena. Ese plan ya está escrito, y es lo que viene.
Lo que el aprendizaje automático no hará (esto lo decidí el 29 de octubre) es pilotar el juego. Su trabajo es producir datos, buscar fuera del juego los mejores valores de cada perfil de piloto, por figura y por emparejamiento, mientras el juego sigue leyendo números legibles y deterministas. Una política aprendida como cerebro alternativo queda para después de la 1.0, y me parece bien que así sea.
6 - Palabras finales
El contrato de determinismo que escribí el primer día, pensando en el multijugador, me ha dado de rebote, un mes después, un simulador que coincide con el juego en 12 506 duelos y que corre en una gráfica. Lo que más me ha enseñado ha sido la paridad, porque cada diferencia que encontró el conjunto era un fallo del juego o del porte que de otra manera habría pasado desapercibido. Os dejo la pregunta que me hago cada vez que añado una regla: ¿cómo mantenéis la paridad entre un simulador y el juego real a medida que crecen las figuras y las reglas?
6.1 - Para el futuro
La siguiente entrega es la del kit de las figuras: cuatro habilidades al estilo de un MOBA, guardia y parada, una regla de puntería y 120 direcciones, que es lo que ha cambiado la arena el 1 de noviembre.
Orbafall Legions es un proyecto personal no oficial, no afiliado con Silicon Knights, SSI, Mindscape ni Ubisoft.
Versión 1.0R1 (02/11/2026)
Changelog
- Versión 1.0R1 (02/11/2026)
- Enlace a NVIDIA Warp. Repaso de redacción.
- Versión 1.0R0 (31/10/2026)
- Versión inicial.