A primera hora del 31 de octubre, los lotesUn conjunto de partidas o combates simulados de una tacada, con la misma configuración, para medir algo con cifras en lugar de con impresiones. de partidas entre IA me trajeron un atasco nuevo: en el nivel máximo de dificultad, con dos ejércitos iguales, nadie atacaba nunca, y ocho de ochenta partidas llegaban al tope de rondas sin un solo combate decisivo. La causa llevaba días a la vista (y era culpa mía): la IA elegía sus ataques con un paso vorazElegir en cada paso lo que más rinde ahora mismo, sin mirar más allá. En inglés, greedy. que solo miraba si el intercambio salía a cuenta, y en un espejo de ejércitos iguales todo intercambio sale perdiendo. Esa mañana, con el café, escribí esto, y de ahí parte la entrega:
La estrategia en el tablero debe ver más allá de si el siguiente movimiento mata o no a la pieza que atacaría. Importa valorar la posición de su figura, dónde quedaría de ganar el intercambio, qué tipo de presión ejercería en esa posición (a nivel estrategia general del tablero por zona de influencia, y táctica específica de la zona activa, como en el juego de mesa Go), y por supuesto el hostigamiento esperado sobre una pieza aunque en el intercambio sea negativo (es posible que pierda la pieza, pero mermar la vida de esa otra pieza conviene por la estrategia).
Es la primera de las dos píldoras de diseño de la serie, y la más larga, así que mejor con un café. Va de lo que barrunté aquel día y de lo que se implementó en las veinticuatro horas siguientes: una sola evaluación de la posición, una búsqueda que trata cada combate como un nodo de azar, una variedad controlada y una dificultad sobre una campana de Gauss.
1 - Qué quiere la IA
Lo que quiere la IA es ganar la partida, y para eso mueve sus figuras, así que cada movimiento debería valorarse en consecuencia, más allá de si mata o no a la figura que va a atacar a continuación (y, si hay más jugadores en su equipo, pensando también en el bien común). Esa fue mi primera pregunta de la sesión de diseño, junto con otra que me hago mucho: ¿cómo lo hacen los referentes de la industria?
Grosso modo, y por lo que entendí, los motores de ajedrez clásicos evalúan una posición con una suma de términos legibles [material, movilidad, seguridad del rey] cuyos pesos se ajustan (en lugar de fijarse a mano) para que la evaluación prediga quién gana, y buscan en el árbol de jugadasTodas las jugadas posibles desde una posición y, para cada una, las réplicas posibles, y así sucesivamente. Crece tan deprisa que hay que podarlo. podando las malas. Los programas de Go anteriores a AlphaGoEl programa de DeepMind que en 2016 venció al campeón de Go Lee Sedol con redes neuronales, cuando el Go se consideraba fuera del alcance de las máquinas., por su parte, usaban funciones de influencia: cada piedra irradia su valor a las intersecciones cercanas, con caída por distancia, y así se sabe de quién es cada zona del tablero. Mi juego tiene un poco de cada, piezas con valor y un tablero donde el territorio importa, así que la decisión fue una sola evaluación de la posición que dirija tanto los ataques como las marchas; hasta entonces, el ataque se decidía antes y aparte.
2 - Los términos de la evaluación
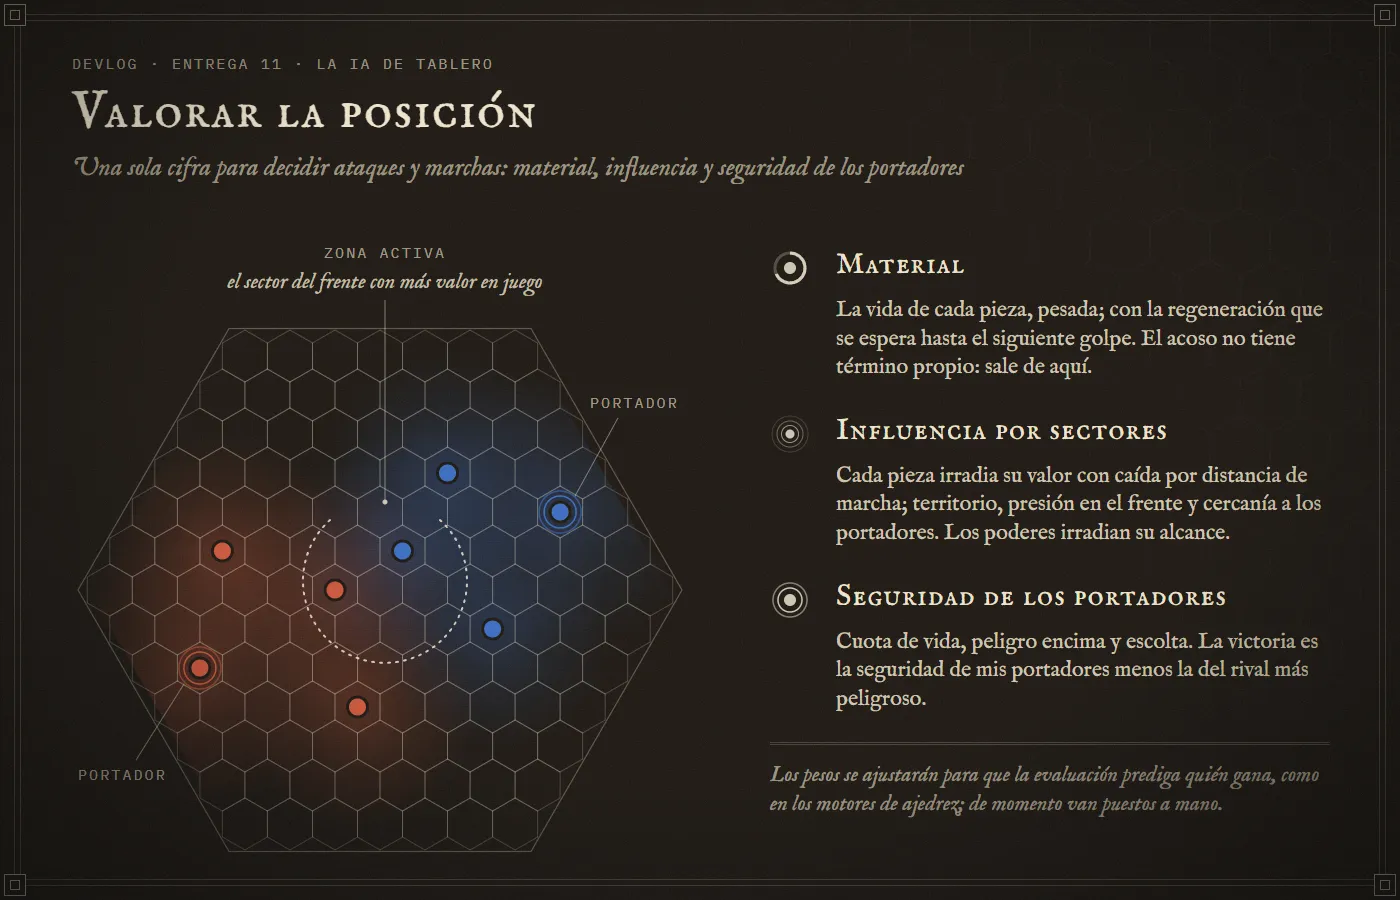
Imagen 1. Valorar la posición: material, influencia por sectores y seguridad de los portadores, en una sola cifra.
La evaluación de una posición suma tres términos, y me gusta que cada uno se pueda contar en una frase (más o menos).
Material. La vida de cada pieza, con su peso y con la regeneración que se espera hasta el siguiente golpe probable. El acoso no tiene término propio, sale de aquí: si daño a una pieza rival sin matarla, la evaluación sube, que es justo lo que el paso voraz no veía. La evaluación es del bando entero, con una perilla que dice cuánto pesa lo de un aliado frente a lo propio.
Influencia por sectores. Cada pieza irradia su valor con caída por distancia de marcha, y la cuenta se hace por sectores del tablero y no casilla a casilla, que en un hexágono grande sería carísimo. De ahí salen el territorio de cada bando, la presión en el frente y la cercanía a los portadores. La zona activa es el sector del frente con más valor en juego, y en ella la búsqueda gasta más candidatos; es mi manera de traer al tablero lo de la táctica local del Go. La influencia de cada pieza incluye, además, el alcance y el área de sus poderes, leídos de sus datos, de modo que una figura que congela a distancia irradia presión hasta donde llega su poder. Esto me importaba mucho: quería que un poder pesase en la estrategia, más allá de la táctica del turno, y que un mod con una figura nueva lo aprovechase sin tocar la IA.
Seguridad de los portadores. La de cada portador sale de su cuota de vida, del peligro que tiene encima y de su escolta, y el término de victoria es la seguridad de mis portadores menos la del bando rival más peligroso. Lo que no tiene término propio es la posición tras ganar: en la rama en la que gana el atacante, la búsqueda lo pone en la casilla del defensor, con la vida que le queda, y evalúa desde ahí, que me pareció más honesto que inventarse un término para ello.
Y luego están los pesos. Mi primera intuición fue preguntar si aquello no podía ser una suma de términos con pesos ajustados junto con una probabilidad aprendida, y lo que quedó es casi eso: los pesos se ajustan como un modelo logísticoUn modelo estadístico que convierte una suma de términos con pesos en una probabilidad entre 0 y 1. Aquí, la probabilidad de ganar la partida desde una posición. de la probabilidad de ganar sobre partidas del simulador, como en los motores de ajedrez, y el evaluador aprendido del que hablaré en la siguiente entrega queda como vara de medir, fuera de la suma. A 1 de noviembre, lo confieso, los pesos siguen puestos a mano: la herramienta de ajuste está lista, pero la corrida se aplazó hasta que el simulador juegue partidas enteras de tablero, así que esto puede cambiar.
3 - Cada combate es un nodo de azar
La búsqueda es un expectimaxUna búsqueda en el árbol de jugadas con tres tipos de nodo: los míos, donde elijo lo mejor; los del rival, que elige lo peor para mí; y los de azar, donde cada salida se pondera por su probabilidad.. En ajedrez, el árbol alterna mis jugadas y las réplicas del rival; aquí tiene además nodos de azar, porque un ataque en el tablero se resuelve en una arena, con su incertidumbre. Cada combate es un nodo con tres ramas (gana el atacante, gana el defensor o mueren los dos), con las probabilidades que da la tabla de resultado esperado de la entrega 7 y con la vida que le queda al ganador. El rival minimiza, y con tres bandos o más solo responde el más peligroso, una simplificación conocida en juegos de más de dos jugadores. Como antes, hay un haz de candidatosLa búsqueda solo sigue las mejores jugadas de cada nivel, unas pocas, en lugar de todas. En inglés, beam. y una poda por margenDescartar las jugadas que quedan a más de cierta distancia de la mejor, para no gastar tiempo en ellas., y la memoria de lo que la IA tenía intención de hacer se guarda por turno, en lugar de por cada vista del tablero.
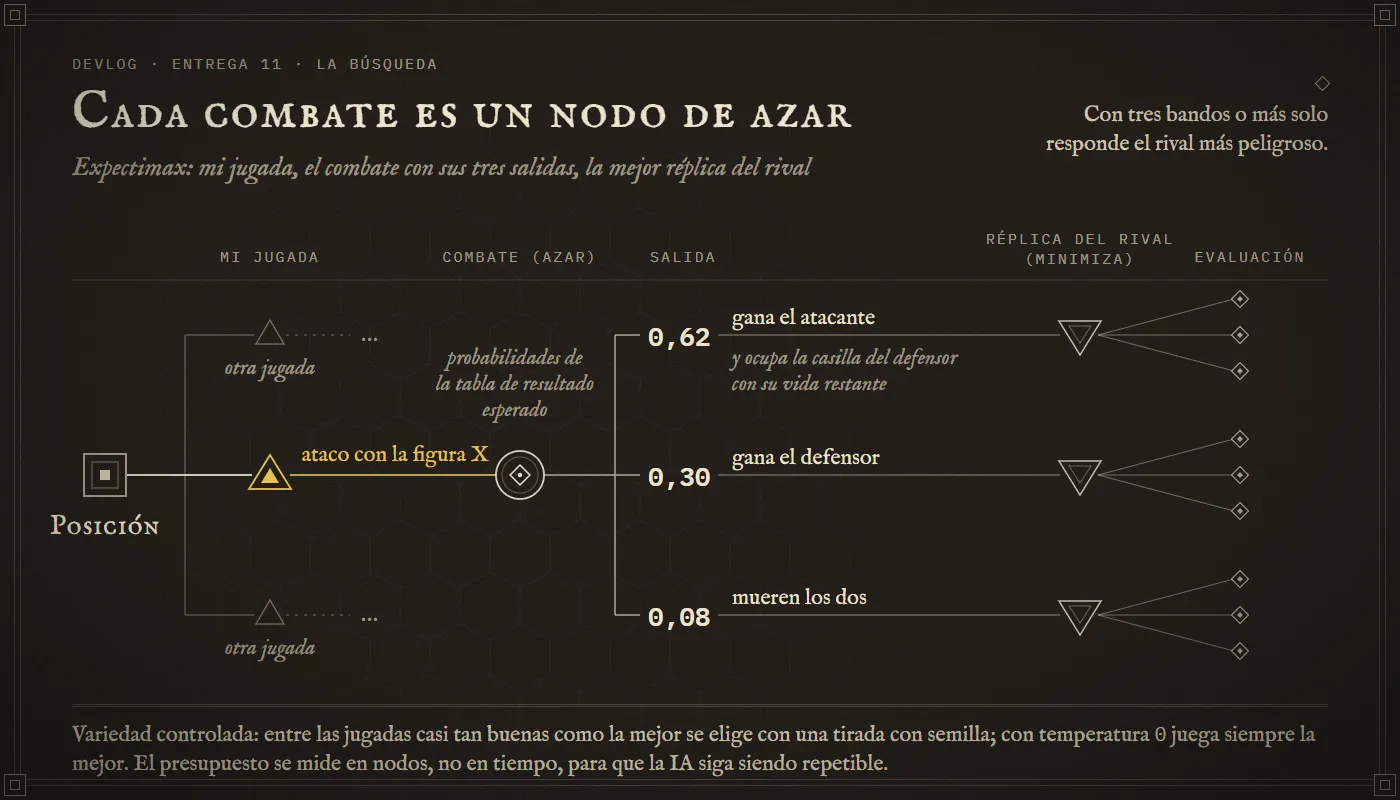
Imagen 2. Expectimax: mi jugada, el combate con sus tres salidas y la mejor réplica del rival.
Sobre el presupuesto de la búsqueda, lo que firmé es que se mide en nodos y nunca en tiempo, para que la IA siga siendo una función pura de lo que ve y la misma partida, con la misma semilla, dé la misma jugada en cualquier máquina. Ese presupuesto se calibra contra el tiempo en el hardware de referencia, con unos dos segundos como guía y algo más de holgura en los niveles altos. Quiero un juego dinámico, pero también entretenido y retador (retador hasta donde el jugador decida al elegir la dificultad), y la interfaz mostrará que la IA está pensando mientras se animan las jugadas.
4 - Que no sea siempre predecible
Pedí también un factor de aleatoriedad, para que en la misma posición la IA no juegue siempre lo mismo. Lo que salió es una variedad controlada: entre las jugadas que quedan dentro de un margen de la mejor, elige con una distribución de temperaturaUn parámetro que reparte la elección entre opciones según su valor. A temperatura cero se elige siempre la mejor; cuanto más alta, más se reparte entre las casi igual de buenas. El nombre viene de la física estadística., con un flujo de azar propio y con semilla, de modo que todo sigue siendo repetible. A temperatura cero juega siempre la mejor, y cuanto más alta, más se permite jugadas casi tan buenas. Esto sustituye al error uniforme de antes, con el que un nivel bajo se equivocaba al azar y sin criterio, y me parece una forma más creíble de que una IA fácil juegue peor: con jugadas razonables que no son la mejor, en lugar de con disparates.
5 - Lo que pasó
El plan entró el 1 de noviembre, y lo primero que miré, claro, fue el atasco en espejo: de ocho partidas al tope de ochenta se pasó a cero de ochenta, y en el segundo lote terminaron cuarenta y ocho de cuarenta y ocho. En el mismo plan, el cerebro de la arena pasó a juzgar el alcance con una vista coherente de los dos luchadores; antes comparaba su posición actual con la del rival de dos ticks atrás, y en los combates espejo eso dejaba a dos figuras entrando y saliendo sin llegar a tocarse. Todavía queda un caso, un espejo exacto de una figura concreta que sigue llegando al tope de tiempo [se cruzan dentro de los ticks ciegos tras un arranque o un giro], y la regla de anticipación o de paciencia que lo resolvería se decidirá con los pilotos nuevos.
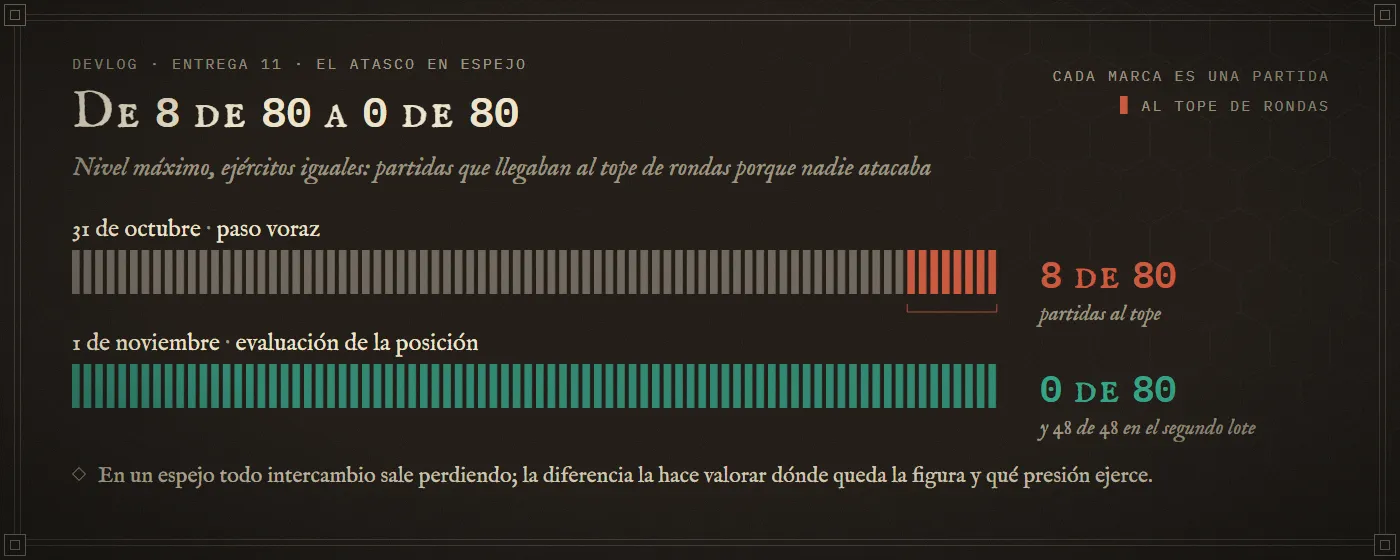
Imagen 3. El atasco en espejo del nivel máximo, antes y después de la evaluación de la posición.
6 - La dificultad sobre una campana
La segunda mitad de la sesión fue la dificultad, y ahí me sentí en casa, porque pensar la habilidad de una población como una distribución es el pan de cada día en mi oficio. Escribí esto, con los números inventados (y avisando de que lo eran):
Me imagino los tramos de dificultad netos como las N medianas de los N intervalos de la gaussiana (¿5?), y la dificultad adaptativa sería semejante pero centrando la gaussiana con el Elo del jugador y eligiendo el comportamiento de la IA al instanciar la partida en las inmediaciones de la posición del jugador. De ese modo, un jugador con 1500 de Elo, si quiere una partida «fácil» regular, se le asignaría, qué sé yo, una IA de Elo 600, pero si quiere una partida «fácil» adaptativa, se le asignaría una IA de 1200 de Elo.
Al día siguiente lo firmé con cifras. Antes pedí que me calculasen las dos formas de repartir los tramos, con sus distribuciones, y las abrí en un editor para estudiarlas con calma, porque la decisión no era obvia. Cinco tramos sobre una gaussianaLa campana de Gauss: la distribución en la que la mayoría se agrupa en torno a la media y los extremos son raros. Un sigma es su desviación típica: el 68 % de la gente queda a menos de un sigma de la media. del EloEl sistema de puntuación del ajedrez. Cada partida mueve la puntuación de los dos jugadores según el resultado y la diferencia que había entre ellos. de los jugadores se pueden repartir a igual probabilidad, de modo que cada tramo cubra a un quinto de la población, o a igual anchura, un sigma cada uno. Con la primera, la persona media gana el 86, 68, 50, 32 y 14 por ciento de las partidas contra los cinco tramos; con la segunda, el 95, 81, 50, 19 y 5. Lo que inclinó la balanza fue el principiante: con tramos de igual anchura, alguien en el 5 por ciento más flojo gana el 63 por ciento de las partidas al tramo fácil, y con igual probabilidad, solo el 37. Yo quería cubrir tanto al principiante como al experto, así que me quedé con la igual anchura, a un sigma, y que el adaptativo afine el centro.
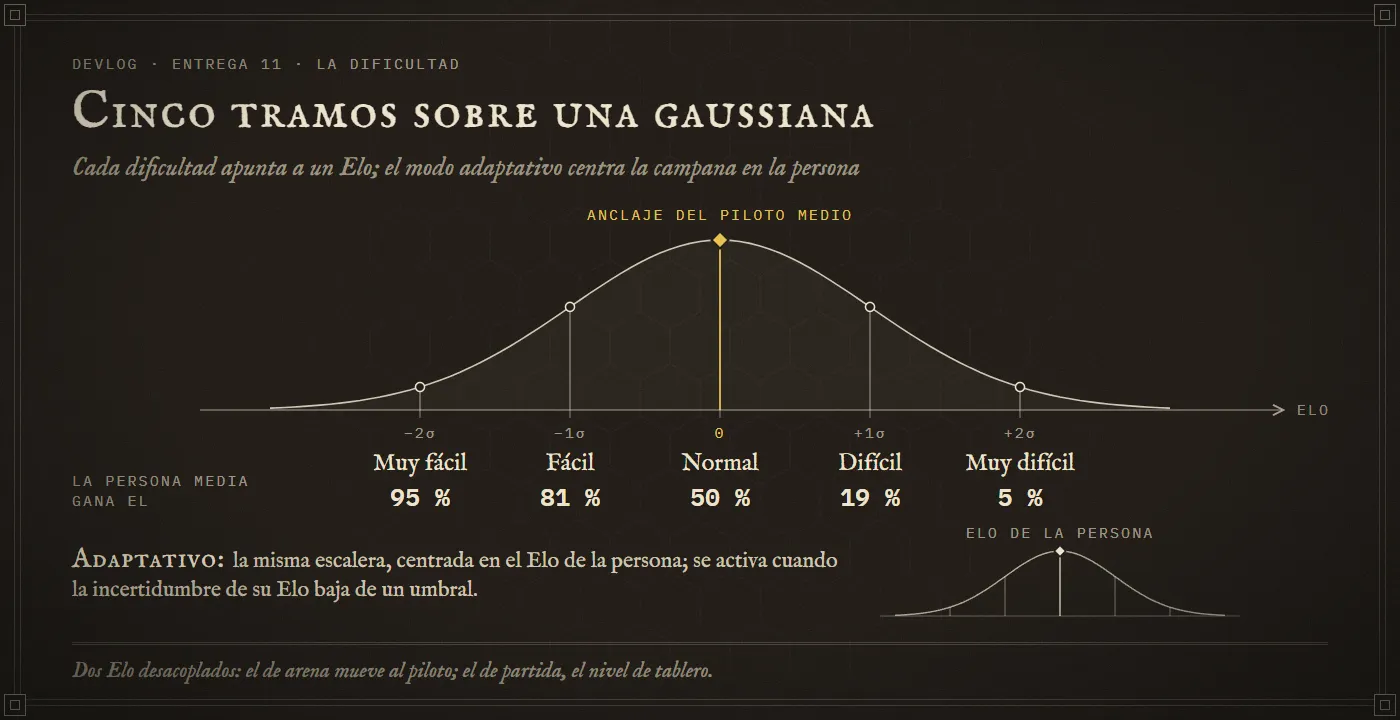
Imagen 4. Cinco tramos sobre una gaussiana del Elo, y el adaptativo centrado en la persona.
Lo demás que firmé ese día:
- Dos Elo desacoplados, cada uno con su incertidumbre. El de arena se mueve solo con arenas jugadas, también en el modo de solo arenas y en las liguillas, y nunca con las resueltas automáticamente; el de partida, solo con partidas de tablero, aunque sus arenas sean automáticas. El de arena mueve al pilotoEl perfil de destreza con el que la IA lleva una figura en la arena: cuánto tarda en reaccionar, cuánto adelanta al apuntar, cuánto duda.; el de partida, el nivel de tablero.
- El adaptativo usa la misma escalera de tramos centrada en la persona, y solo se activa cuando la incertidumbre de su Elo baja de un umbral; antes se juega el tramo fijo elegido. Con varias personas, mira la peor incertidumbre y centra en la media ponderada por precisión. Y, como siempre, la IA juega igual contra todos durante la partida. En una campaña se puede elegir adaptativo: las primeras partidas sirven para fijar la incertidumbre, y después se activa. Aquí reconocí que estaba hablando sin conocimiento, y lo mantengo.
- Nueve pilotos de arena en lugar de tres: los cinco de los tramos y cuatro intermedios a medio sigma, con las perillas interpoladas entre vecinos y calibrados en el simulador, de modo que el adaptativo tiene pasos de unos 125 puntos. Todas las perillas crecen juntas de un piloto al siguiente [adelanto al apuntar, reacción, dudas, guardia, parada, error], para que ninguna dimensión de la destreza quede invertida. Me pregunté si duplicar los pilotos costaría mucho, y la respuesta es que para eso están las simulaciones en la GPU.
- Las ventajas siguen apagadas, salvo en el último tramo y solo si el piloto más fuerte con el nivel más alto no alcanza su objetivo.
7 - Palabras finales
Me queda la sensación, un poco vertiginosa, de haber diseñado en un día algo sobre lo que leía la semana anterior, y el consuelo de que casi todo lo que firmé lleva al lado un número que se puede medir (el 48 de 48, los cinco porcentajes de los tramos). Lo que no sé es si los pesos ajustados ganarán a los puestos a mano, si cinco tramos se sentirán bien a quien juegue, ni cómo se consigue que una IA fácil se equivoque de forma creíble; esta última va de pregunta para vosotros, y si tenéis experiencia con ello, os lo agradeceré mil.
7.1 - Para el futuro
La siguiente entrega es la otra píldora: cómo se comprueba que un simulador en la tarjeta gráfica coincide con el juego en 12 506 duelos, y qué aprendió una red que jugaba contra sí misma a dieciocho mil partidas por segundo.
Orbafall Legions es un proyecto personal no oficial, no afiliado con Silicon Knights, SSI, Mindscape ni Ubisoft.
Versión 1.0R1 (02/11/2026)
Changelog
- Versión 1.0R1 (02/11/2026)
- Repaso de redacción.
- Versión 1.0R0 (30/10/2026)
- Versión inicial.